L’analisi predittiva nello sport usa modelli statistici e machine learning per trasformare tracking, wearable e dati di partita in decisioni misurabili su prestazioni, tattica e prevenzione degli infortuni. Metriche come gli expected goals (xG) e algoritmi come Random Forest e XGBoost stimano probabilità, non certezze. Il loro valore sta nel ridurre l’incertezza dove allenatori, staff medico e gestori devono scegliere ogni settimana.
In breve:
- Le revisioni riportano per i modelli ad alberi un’AUC media vicina a 0,77: valuta anche F1 e calibrazione, soprattutto quando gli infortuni sono rari.
- Random Forest richiede poca messa a punto e gestisce bene dati eterogenei; XGBoost può estrarre più segnali da campioni moderati, ma dipende maggiormente dai parametri.
- Definisci prima la decisione e il relativo orizzonte, poi concorda una soglia d’allerta e registra gli interventi per verificare periodicamente la calibrazione.
- Se il club ha pochi atleti e pochi infortuni, non addestrare il modello soltanto sui propri dati: parti da carico e recupero, adattando con cautela modelli pubblicati.
- Prima di acquistare sensori, controlla qualità e coerenza dei dati esistenti; per quelli biometrici servono consenso specifico, accessi limitati e tempi di conservazione definiti.
Indice
- Cos’è l’analisi predittiva sportiva e quali termini ti servono
- Random Forest, XGBoost ed ensemble: come funzionano i modelli più usati
- Dalla tattica alla prevenzione: come i modelli si traducono in decisioni
- Cosa dicono le evidenze scientifiche e dove sono i limiti
- Come partire in un club o centro sportivo: una roadmap in sei passi
- Il mio punto di vista: parti da poco e fai crescere il sistema
- Dai dati alle decisioni operative: come ti aiutiamo a gestire il tuo centro
- Domande frequenti
- Fonti
Cos’è l’analisi predittiva sportiva e quali termini ti servono
Per orientarti conviene partire da una distinzione. L’analisi descrittiva racconta che cosa è successo: quanti chilometri ha corso un giocatore, quanti tiri ha concesso una squadra. L’analisi predittiva stima che cosa è probabile che accada: la probabilità di un risultato, il rischio di un infortunio nelle prossime settimane, la fascia oraria in cui un campo si riempirà. L’analisi prescrittiva fa un passo in più e suggerisce che cosa fare: ridurre il carico di un atleta, cambiare un assetto, spostare una promozione.
Chi lavora con questi strumenti incontra presto un lessico preciso. Eccolo, senza fronzoli:
- Expected goals (xG): la probabilità che un tiro diventi gol, calcolata dalla posizione, dall’angolo e dal tipo di azione. Sommati su una partita, misurano la qualità delle occasioni create e concesse.
- AUC: l’area sotto la curva ROC, che misura quanto un modello distingue gli eventi dai non eventi. Vale 0,5 per una scelta casuale e 1 per una separazione perfetta.
- Calibrazione: il grado in cui le probabilità dichiarate corrispondono alle frequenze reali. Se le probabilità sono ben calibrate, gli eventi si verificano con una frequenza vicina a quella prevista.
- SHAP: un metodo che attribuisce a ogni variabile il suo contributo a una singola previsione, utile per spiegare perché un atleta risulta a rischio.
- Feature importance: la graduatoria globale delle variabili che pesano di più nel modello.
- F1: la sintesi di precisione e richiamo, importante quando gli eventi da prevedere, come gli infortuni, sono rari.
C’è poi una questione che si sottovaluta: quando una previsione è davvero applicabile? Dipende dalla granularità temporale. Prevedere il risultato di una partita a pochi minuti dal fischio d’inizio, con formazioni note, è un problema diverso dallo stimare il rischio di infortunio «nella prossima stagione». Finestre troppo ampie producono numeri che sembrano buoni ma non cambiano nessuna decisione. Una previsione utile arriva in tempo per agire, è espressa come probabilità e indica con chiarezza l’orizzonte a cui si riferisce.
Vale la pena anche chiedersi quali statistiche entrano nel modello. Quelle di partita (tiri, passaggi, pressing), quelle di carico (distanze, accelerazioni, minuti giocati) e quelle contestuali (calendario, riposo, condizioni ambientali) rispondono a domande differenti. Mescolarle senza un obiettivo preciso è il modo più rapido per ottenere un modello complicato e poco utile. Prima di scegliere l’algoritmo, quindi, si sceglie la decisione che la previsione deve sostenere.
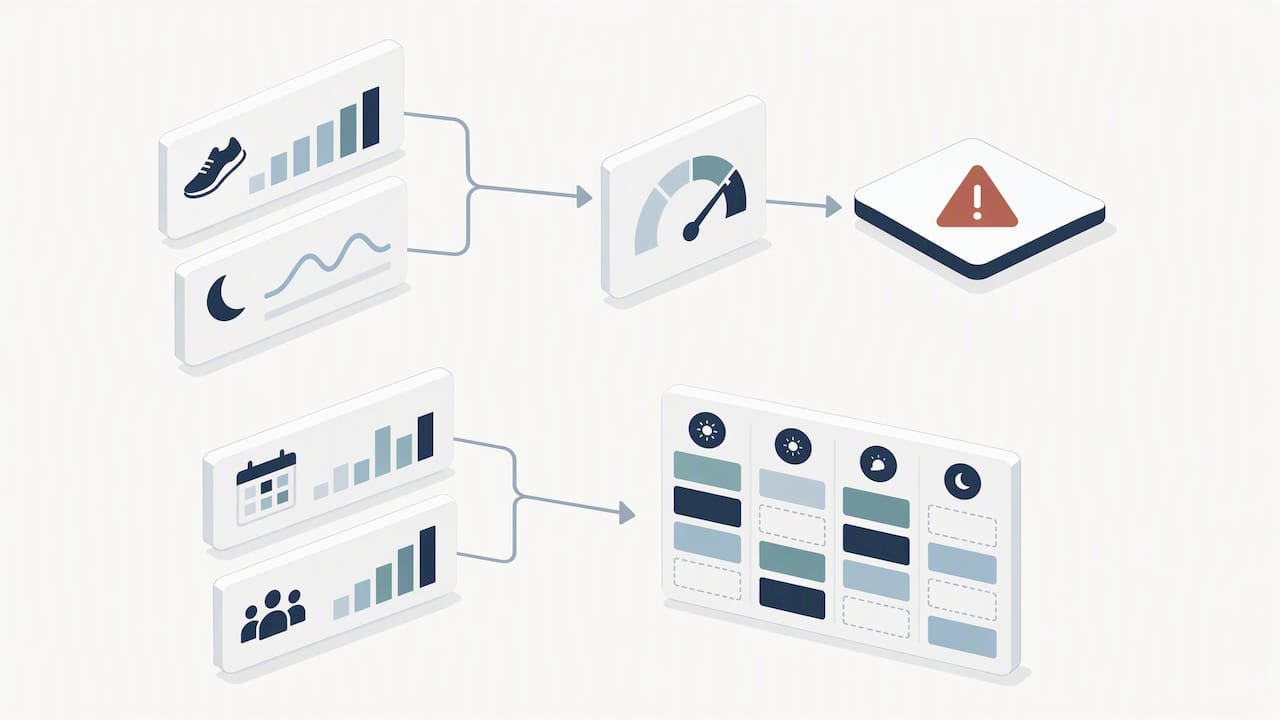
Un esempio concreto aiuta. Un allenatore che vuole decidere se far riposare un attrezzista dopo partite ravvicinate non ha bisogno di una previsione stagionale, ma di una stima del rischio a breve termine, con le variabili che l’hanno prodotta. Un gestore di centro sportivo che vuole riempire gli slot vuoti ha bisogno di una previsione giornaliera o oraria della domanda. Stessa disciplina, orizzonti e dati diversi.
Random Forest, XGBoost ed ensemble: come funzionano i modelli più usati
Tra i modelli che compaiono con più frequenza nella letteratura sportiva ci sono due famiglie basate su alberi decisionali. Una scoping review sull’apprendimento automatico per la predizione del rischio di infortunio ha rilevato che Random Forest e XGBoost sono spesso le tecniche con le prestazioni migliori, pur con un’eterogeneità metodologica che ne limita la generalizzabilità.
Random Forest costruisce molti alberi decisionali su sottoinsiemi casuali dei dati e delle variabili, poi ne media i voti. Il risultato è un modello robusto al rumore, che richiede poca messa a punto e gestisce bene variabili di natura diversa. XGBoost procede invece in sequenza: ogni nuovo albero corregge gli errori dei precedenti, con una regolarizzazione che frena il sovradattamento. Di solito è più sensibile ai parametri, ma può spremere più segnale da dataset di dimensioni moderate.
Perché sono così diffusi nello sport? Perché i dati sportivi sono tabellari, spesso piccoli e pieni di valori mancanti, e gli alberi se la cavano meglio delle reti neurali quando i campioni sono ridotti. Inoltre si prestano all’interpretazione: con SHAP e feature importance puoi mostrare a un preparatore atletico quali segnali hanno spinto il rischio di un giocatore.
La misura della prestazione. Nelle review sull’infortunio l’AUC è la metrica più comune, e la prestazione media dei metodi basati su alberi è stata riportata intorno a 0,77. È un valore discreto, non eccezionale, e va letto insieme a F1 e calibrazione, soprattutto quando gli eventi positivi sono pochi.
Un’AUC media intorno a 0,77 per i metodi tree-based nelle studi di predizione degli infortuni: una scoping review la riporta come prestazione tipica, con una forte eterogeneità tra gli studi. Significa che i modelli discriminano meglio del caso, ma non abbastanza da sostituire il giudizio dello staff.
Gli ensemble. Combinare più modelli riduce gli errori idiosincratici di ciascuno. Nel calcio, per le previsioni sul risultato, la metodologia di PronoStats descrive modelli di nuova generazione che usano ensemble, affiancati da modelli linguistici (LLM) per interpretare fattori qualitativi non strutturati, come il clima di uno spogliatoio o una notizia sulla formazione. Lo stesso approccio prevede un blending con le quote di mercato per bilanciare l’efficienza del mercato con le previsioni basate sui dati.
Un modello 1X2 completo, che stima le probabilità di vittoria casalinga, pareggio e vittoria ospite, integra tipicamente:
- gli xG creati e concessi, per misurare la qualità delle occasioni oltre il risultato;
- un rating come Glicko-2, che aggiorna la forza delle squadre e ne tiene conto dell’incertezza;
- variabili contestuali come meteo, motivazione, assenze e infortuni;
- una calibrazione finale, che rende le probabilità coerenti con le frequenze osservate.
La guida di PronoStats descrive proprio questa combinazione di fonti in tempo reale con ensemble di Random Forest e XGBoost, calibrazione e blending per generare probabilità e mercati multipli.
L’interpretabilità merita un’attenzione a parte. Un modello che non sai spiegare difficilmente convincerà un allenatore o un medico sportivo. SHAP permette di dire, per esempio, che il rischio di un atleta è cresciuto soprattutto per un aumento brusco del carico settimanale e per pochi giorni di recupero. È un’informazione su cui si può agire, a differenza di un punteggio opaco.
Un ultimo punto riguarda l’uso dei modelli linguistici. Un LLM non produce da solo la probabilità: legge testo (conferenze stampa, notizie, bollettini medici) e lo trasforma in segnali strutturati che entrano nell’ensemble. Conviene trattarlo come un ingresso da validare, perché può sbagliare o inventare, e verificarne l’effetto sulla calibrazione prima di fidarsene.
Dalla tattica alla prevenzione: come i modelli si traducono in decisioni
Le applicazioni più concrete si raccolgono in tre ambiti. Il primo è la tattica: un modello che stima le probabilità di risultato e che confronta gli xG delle diverse configurazioni di gioco aiuta a scegliere assetti, momenti per cambiare e priorità di allenamento. Non decide al posto dell’allenatore, ma gli offre una seconda lettura fondata sulla qualità delle occasioni e non solo sul punteggio finale.
I dati di carico possono aiutare a personalizzare gli allenamenti e a individuare gli atleti che stanno rispondendo meno bene allo stesso stimolo. Il monitoraggio del carico, incrociato con questionari sul recupero, può offrire elementi utili per decidere se intervenire.
Il terzo ambito è la prevenzione degli infortuni, dove i modelli lavorano come sistemi di allerta: stimano un rischio e lo confrontano con una soglia concordata con lo staff medico. Una review sull’intelligenza artificiale per la predizione e prevenzione delle lesioni al legamento crociato anteriore riporta risultati variabili per i modelli di machine learning, evidenziando però che campioni ridotti e costi strumentali ostacolano l’adozione pratica. È un quadro che invita all’ambizione prudente: i numeri sono promettenti, ma dipendono molto dal contesto.
Anche il ritorno allo sport entra nel campo di applicazione. Una revisione sistematica sui modelli di machine learning per prevedere il rientro degli atleti dopo un infortunio mostra che Random Forest è l’algoritmo più usato e che le prestazioni possono essere buone, con limiti nella generalizzabilità e nella definizione degli esiti. Per chi gestisce il rientro, una checklist per tornare ad allenarsi in sicurezza aiuta a tradurre le probabilità in tappe concrete, con criteri funzionali verificabili.
Per passare dal modello all’azione, una sequenza di lavoro semplice funziona bene:
- Definisci la decisione che il modello deve supportare e chi la prende (allenatore, medico, direttore sportivo).
- Scegli un orizzonte di previsione coerente con quella decisione, per esempio la settimana successiva.
- Concorda con lo staff una soglia di allerta e l’azione associata a ciascun livello di rischio.
- Mostra insieme alla probabilità le variabili che l’hanno prodotta, con SHAP o strumenti simili.
- Registra che cosa è stato fatto dopo l’allerta e come è andata, per misurare l’impatto reale.
- Rivaluta periodicamente la calibrazione del modello sui dati nuovi e aggiorna le soglie.
Il punto debole più comune è saltare il quinto passaggio. Senza la registrazione delle azioni intraprese non saprai mai se un’allerta ha evitato un infortunio o se è stata semplicemente ignorata. Un sistema predittivo diventa utile quando chiude il cerchio tra previsione, intervento e verifica.
Un esempio di buona pratica: un club che ha in rosa pochi atleti e infortuni rari non deve aspettarsi un modello addestrato solo sui propri dati. Più realistico partire da indicatori semplici di carico e recupero, monitorarli con costanza e usare i modelli pubblicati come riferimento, adattandoli poi con cautela alla propria realtà.
Cosa dicono le evidenze scientifiche e dove sono i limiti
Le rassegne disponibili convergono su un messaggio: i modelli funzionano meglio del caso, ma i risultati sono molto variabili. Una revisione sistematica su metodi di machine learning per la predizione e prevenzione degli infortuni riporta risultati molto variabili e suggerisce che l’interpretazione dei modelli e la qualità degli studi debbano migliorare. Un’altra rassegna sulle applicazioni dell’intelligenza artificiale nei team sport indica la prevalenza di reti neurali, alberi decisionali e SVM in sport come calcio, basket e pallavolo, e la necessità di valutazioni prospettive per stabilire la reale capacità predittiva.
Una systematic review sui modelli di machine learning per le lesioni al legamento crociato anteriore mostra risultati variabili, segno che la prestazione dipende da dati, definizioni e contesto più che dall’algoritmo scelto.
I limiti ricorrono con una regolarità quasi noiosa:
- Eterogeneità metodologica: studi con dati, definizioni e protocolli diversi sono difficili da confrontare e da replicare.
- Dimensioni dei campioni: pochi atleti ed eventi rari espongono al rischio di sovradattamento e di AUC ottimistiche.
- Definizione di infortunio: quando un’assenza di un giorno e una rottura legamento sa finiscono nella stessa etichetta, la previsione perde significato clinico.
- Finestre di previsione: orizzonti troppo ampi producono AUC discrete ma poco utili all’azione quotidiana.
- Validazione: pochi studi testano i modelli in modo prospettico, su squadre diverse da quelle di addestramento.
Le raccomandazioni che emergono sono pragmatiche: dataset più grandi e condivisi, definizioni standard di infortunio, modelli interpretabili e una collaborazione stretta tra scienziati dei dati, staff medico e allenatori. La stessa UEFA porta avanti programmi di ricerca e di monitoraggio degli infortuni e della sicurezza dei giocatori, con iniziative di condivisione dei dati e linee guida su commozioni cerebrali e prevenzione.
Come partire in un club o centro sportivo: una roadmap in sei passi
Non serve un laboratorio di data sciente per cominciare. Serve un percorso ordinato, con obiettivi piccoli e misurabili. Questa sequenza funziona sia per un club professionistico sia per un centro sportivo che gestisce campi, soci e tornei:
- Definisci l’obiettivo. Scegli una sola decisione da migliorare: ridurre gli slot vuoti, individuare i soci a rischio abbandono, anticipare i picchi di carico degli atleti.
- Fai l’inventario dei dati. Elenca che cosa raccogli già, in quale formato, con quale frequenza e con quale qualità. Spesso hai più materiale di quanto pensi.
- Scegli KPI pertinenti. Per esempio tasso di occupazione, frequenza media dei soci, tempo che passa dal dato alla decisione, accuratezza calibrata delle previsioni.
- Avvia un progetto pilota. Un ambito, un periodo di prova e un responsabile. Meglio un modello semplice e capito da tutti che uno sofisticato e ignorato.
- Misura e confronta. Verifica la previsione contro la realtà, controlla la calibrazione e valuta l’impatto operativo: ore di campo riempite, infortuni evitati, tempo risparmiato.
- Itera e scala. Correggi ciò che non funziona, poi estendi ad altri ambiti solo quando il primo regge.
Le competenze necessarie sono meno esotiche di quanto sembri: qualcuno che conosca il dominio (allenatore, medico, direttore del centro), qualcuno che sappia lavorare con i dati e qualcuno che ne garantisca la qualità e la conformità. In una struttura piccola questi ruoli possono essere ricoperti da poche persone, purché le responsabilità siano chiare.
Sui KPI conta il pragmatismo. Il tempo-to-insight, cioè quanto passa dalla raccolta del dato a una decisione utile, dice più di mille grafici. L’accuratezza calibrata ti protegge da previsioni sicure di sé ma sbagliate. L’impatto operativo risponde alla domanda che il direttore farà prima o poi: che cosa è cambiato davvero? Per scegliere gli indicatori di un centro sportivo, la nostra raccolta sui KPI per il club sportivo è un buon punto di partenza, mentre nell’articolo su analytics per un club padel spieghiamo quali dati contano davvero in una struttura che vive di prenotazioni.
Un consiglio: registra fin dal primo giorno le previsioni che il modello fa e il risultato che poi si verifica: dopo qualche mese avrai il materiale per misurare la calibrazione, che è la prova più onesta del valore del progetto.
Il mio punto di vista: parti da poco e fai crescere il sistema
La direzione è chiara: video e wearable verranno letti insieme e l’intelligenza artificiale prescrittiva, quella che suggerisce l’azione e non solo la probabilità, diventerà meno rara. Ma il vantaggio competitivo, a mio avviso, non starà in chi possiede l’algoritmo più nuovo. Starà in chi avrà dati puliti, definizioni condivise e una cultura in cui allenatori, medici e analisti si parlano davvero.
Il rischio più sottovalutato è l’illusione della precisione: un numero con due decimali sembra più affidabile di un giudizio esperto, e invece può essere solo meglio vestito. Un modello ben calibrato e spiegabile può aiutare più di uno spettacolare ma opaco. Per questo il mio consiglio operativo è partire da metriche semplici, verificarle contro la realtà e solo dopo aggiungere complessità. Il progetto pilota con un obiettivo stretto resta lo strumento più onesto per scoprire che cosa funziona nella tua realtà, e la collaborazione con la medicina sportiva è ciò che trasforma una probabilità in una decisione responsabile.
— Manfredi Pistone
Dai dati alle decisioni operative: come ti aiutiamo a gestire il tuo centro
Se gestisci un centro sportivo, il tuo problema quotidiano è riempire i campi nelle ore giuste e fidelizzare i soci. Con BookIt offriamo un’unica piattaforma con intelligenza artificiale integrata, pensata per campi di padel, calcio e tennis.
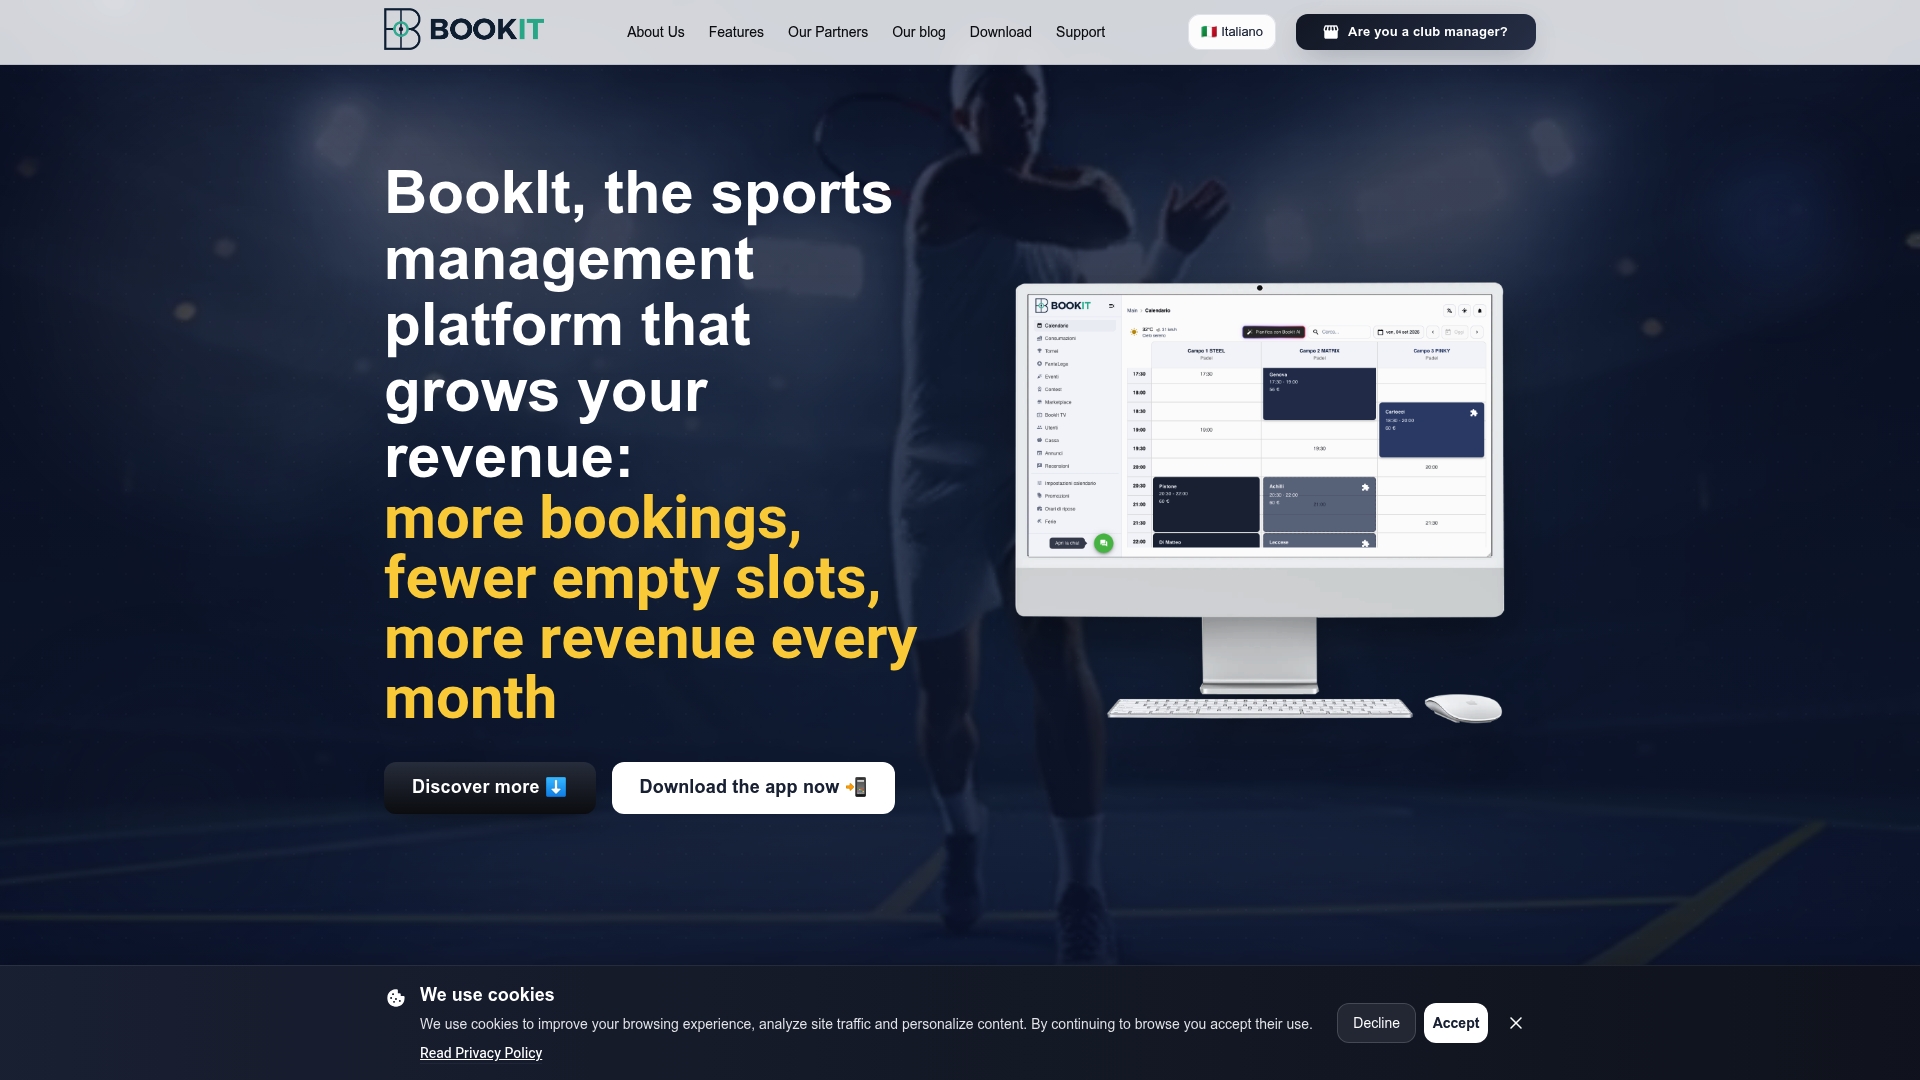
Analizziamo i dati delle prenotazioni per prevedere i periodi di punta e ridurre gli slot vuoti, con una dashboard dei ricavi in tempo reale e la segmentazione dei soci. Le comunicazioni partono in automatico su WhatsApp, i pagamenti passano da Stripe e SumUp, e gestiamo tornei, abbonamenti, membership e lezioni nello stesso ecosistema. In questo modo la previsione non resta un grafico: diventa un’azione, per esempio una promozione mirata negli orari più deboli. Vieni a scoprire come funziona su Bookit-app e chiedi una dimostrazione sul tuo centro. Per approfondire i casi pratici, trovi anche i nostri articoli di AI analytics e la guida all’automazione del marketing per il club sportivo.
Domande frequenti
Cosa si intende per analisi predittiva nello sport?
È l’uso di modelli statistici e di machine learning per stimare la probabilità di eventi futuri a partire da dati storici, come un risultato, un infortunio o la domanda di un campo. Il risultato è una probabilità con un orizzonte temporale preciso, non una certezza.
Quali sono i metodi predittivi più usati?
I più diffusi nella letteratura sono i metodi basati su alberi decisionali, in particolare Random Forest e XGBoost, spesso riportati tra i più performanti in una scoping review sugli infortuni. Si usano anche regressioni, reti neurali ed ensemble che combinano più modelli.
Che cos’è la funzione predittiva di un modello?
È la relazione che il modello apprende tra le variabili in ingresso (carichi, statistiche, contesto) e l’esito da prevedere. Una volta addestrata, la funzione restituisce per ogni nuovo caso una probabilità o un valore stimato.
Quali sono alcuni esempi di modelli predittivi nello sport?
Gli expected goals (xG) stimano la probabilità che un tiro diventi gol. I rating come Glicko-2 aggiornano la forza delle squadre tenendo conto dell’incertezza. I modelli di rischio di infortunio e quelli per il ritorno allo sport usano Random Forest o XGBoost sui dati di carico e clinici.
Un modello predittivo può sostituire il giudizio di allenatori e medici?
No.
Fonti
Un modello vale quanto i dati che riceve. Nello sport le fonti principali sono cinque famiglie, ciascuna con la sua utilità e i suoi limiti:
- Pronostats
- Machine learning approaches to injury risk prediction in sport: a scoping review with evidence synthesis
- Artificial intelligence in ACL injury prediction and prevention: a systematic review – PubMed
Il tema dell’integrazione tra video e wearable è già al centro delle tendenze del settore: il rapporto sulle tendenze 2024 di Catapult, come riporta la pagina sulla metodologia di PronoStats, segnala l’analisi predittiva come «nuova norma» della strategia sportiva, con wearable e video usati insieme per allenamenti personalizzati e mitigazione delle lesioni.
La qualità del dato è il vero collo di bottiglia. I problemi che si incontrano più spesso sono prevedibili:
Prima di costruire qualunque modello vale la pena dedicare tempo a un inventario dei dati: che cosa si registra, con quale frequenza, da chi, con quale definizione. Spesso questo lavoro, poco appariscente, vale più di un algoritmo più sofisticato.
Dati biometrici, consenso e governance. I dati su salute e corpo dell’atleta sono particolarmente sensibili. Una tesi dell’Università di Padova analizza i profili etici e giuridici degli algoritmi predittivi e dei wearable nello sport, sottolineando i rischi legati ai dati biometrici e alla governance. In pratica servono consenso informato e specifico, finalità dichiarate, accessi limitati, tempi di conservazione definiti e chiarezza su chi può vedere che cosa: lo staff medico non ha le stesse esigenze dell’allenatore, e un dato sanitario non dovrebbe mai finire in una discussione contrattuale senza basi chiare. Per i dati sanitari e biometrici, in caso di dubbio, conviene rivolgersi al responsabile della protezione dei dati o a un consulente legale.
Un consiglio: prima di acquistare nuovi sensori, verifica quanti dati utilizzabili hai già e con quale qualità: un anno di registrazioni coerenti con una sola definizione di infortunio vale più di tre sistemi che non si parlano.